







资讯
今晚先领 Epic 喜加二:Undertale 降至$2.49,《神界:原罪2 终极版》降至$11.24
Epic 本周送出的两款游戏,一款是支持本地双人合作的2D动作肉鸽,一款是追求高分的单人街机空战,而且都将在北京时间今晚23:00结束免费领取。若更想买一款 RPG,Undertale 和《神界:原罪2 终极版》也分别降到了 $2.49 和
据报道,朱自清的《荷塘月色》近日被某AI检测工具判定为AI生成率超60%;原文还提到,刘慈欣《流浪地球》片段曾被检出超50%,相关解释来自西湖大学文本智能实验室博士、Fast-DetectGPT研发者之一鲍光胜的说法。
有次我清一张开放世界地图,顺着山脊走到边缘,本来以为前面是空气墙,结果却发现那条路只是没被正确标注。现在看AI检测也是这个感觉,很多人盯着一个“AI率60%”,就以为文章里有60%的句子是机器写的,但实际不是这个意思。按照报道里的解释,它更接近“整篇文章有60%的概率像AI整体生成”,而且工具没法像在地图上插钉子那样,精准指出哪个词、哪句话一定出自AI。
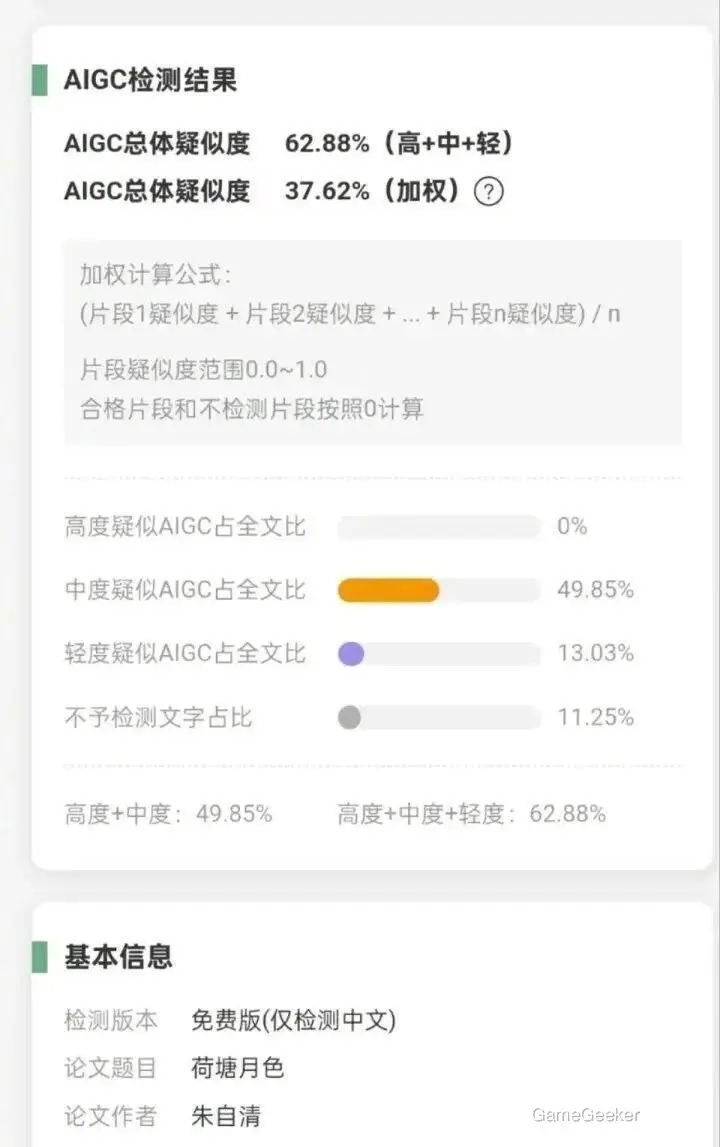
真正值得看的是,为什么连《荷塘月色》这种写于近百年前、全文1361字的经典散文都会被误判。走远一点你会发现,问题不只是工具笨,而是这些名篇早就成了大模型反复见过的“老地标”。检测工具会比对用词、词频分布和模型预测的一致性,经典文本因为表达太成熟、太稳定,反而像在谷歌地图上那条被无数人走过的小路,越熟悉越容易被系统认成“模型味”。
这也解释了为什么误判不是孤例。《流浪地球》片段能被测出超50%,《滕王阁序》甚至能被标成100% AI率。再往外看,同一篇文章丢去不同平台,结果还能相差30%,因为有的算法更看词频,有的更看语法和语义。地图都没统一,你很难指望每个导航把你带到同一个出口。
但地图之外,更让人烦躁的是这个结果正在影响现实判断。报道里提到,100字以下短文本的检测极不可靠,500字左右才有一点参考性,可很多场景偏偏喜欢拿一张检测截图直接下结论。结果就是不少学生原创论文被判高AI率,最后还得反过来证明自己,这种“自证清白”就像明明是正常探索,却被系统先扣了一个越界警告。
顺着这个方向再看,市面上已经出现“卖AI生成服务,再卖降AI率服务”的灰色产业链,本质上就是一场工具和规避工具的攻防战。靠替换高频词去压数值,和某些沙盒游戏里专门研究卡判定、钻机制空子的玩法没区别,最后卷的不是内容本身,而是谁更懂系统漏洞。
如果你平时写稿、写论文,现阶段更稳的建议其实很朴素:别把检测结果当最终裁决,更别为了过检测把文字修成一片模板地形。专家已经说得很明白,检测工具给出的始终是概率,不能作为原创性的唯一标准。对创作者来说,真正有用的反而是把个人风格写深一点,因为AI最擅长模仿共性,最难复刻的恰恰是那些带着个人路径、个人气味的表达。
社区这次会吵起来,也正说明大家已经意识到一件事:AI检测不是终点,它最多只是路牌。路牌能帮你判断方向,但不能替你走完全程,更不能因为一块牌子写错了,就把整片世界都判成假地图。



评论 0
期待听到你的声音
欢迎参与讨论,分享对这款游戏的评价。
暂无评论,欢迎发表评价。